
一、一個反常識的開場:機器人還沒賺錢,數據已經先賺了
先看兩組扎眼的數字。
一邊是本體的估值狂歡。美國 Figure AI 在 2025 年 9 月完成超 10 億美元 C 輪,投后估值飆至 390 億美元,比 18 個月前暴漲約 15 倍;Skild AI 在 2026 年 1 月由軟銀領投約 14 億美元,估值超 140 億美元,七個月翻了三倍;Physical Intelligence 則被傳正洽談約 10 億美元新融資、估值或超 110 億美元。中國這邊同樣火熱:銀河通用 2026 年 3 月完成 25 億元新一輪融資,估值約 225 億元,為國內估值最高的未上市具身公司;宇樹科技 6 月 1 日科創板過會,對應發行市值約 420 億元。
另一邊卻是冰冷的現實:本體公司幾乎都還沒真正賺到錢。優必選連年虧損,多數公司凈利率微薄甚至為負。機器人賣出去了,錢卻沒落進口袋。
那么,誰先賺到了錢?答案是——賣數據的人。
具身數據獨角獸光輪智能,2026 年一季度的單季收入據稱已超過 2025 年全年總和;智元旗下的數據平臺公司覓蜂科技,由紅杉中國領投完成數億元融資。覓蜂 CEO 姚卯青一語道破天機:"在具身智能尚未真正大規模商業化之前,數據作為基礎設施,會比終端應用更早形成商業回報。"
這不是新鮮劇本。AI 圈向來有一條鐵律:淘金熱里最先穩定賺錢的,永遠是賣鏟子、賣牛仔褲的人。如今,具身智能正在重演這一幕。
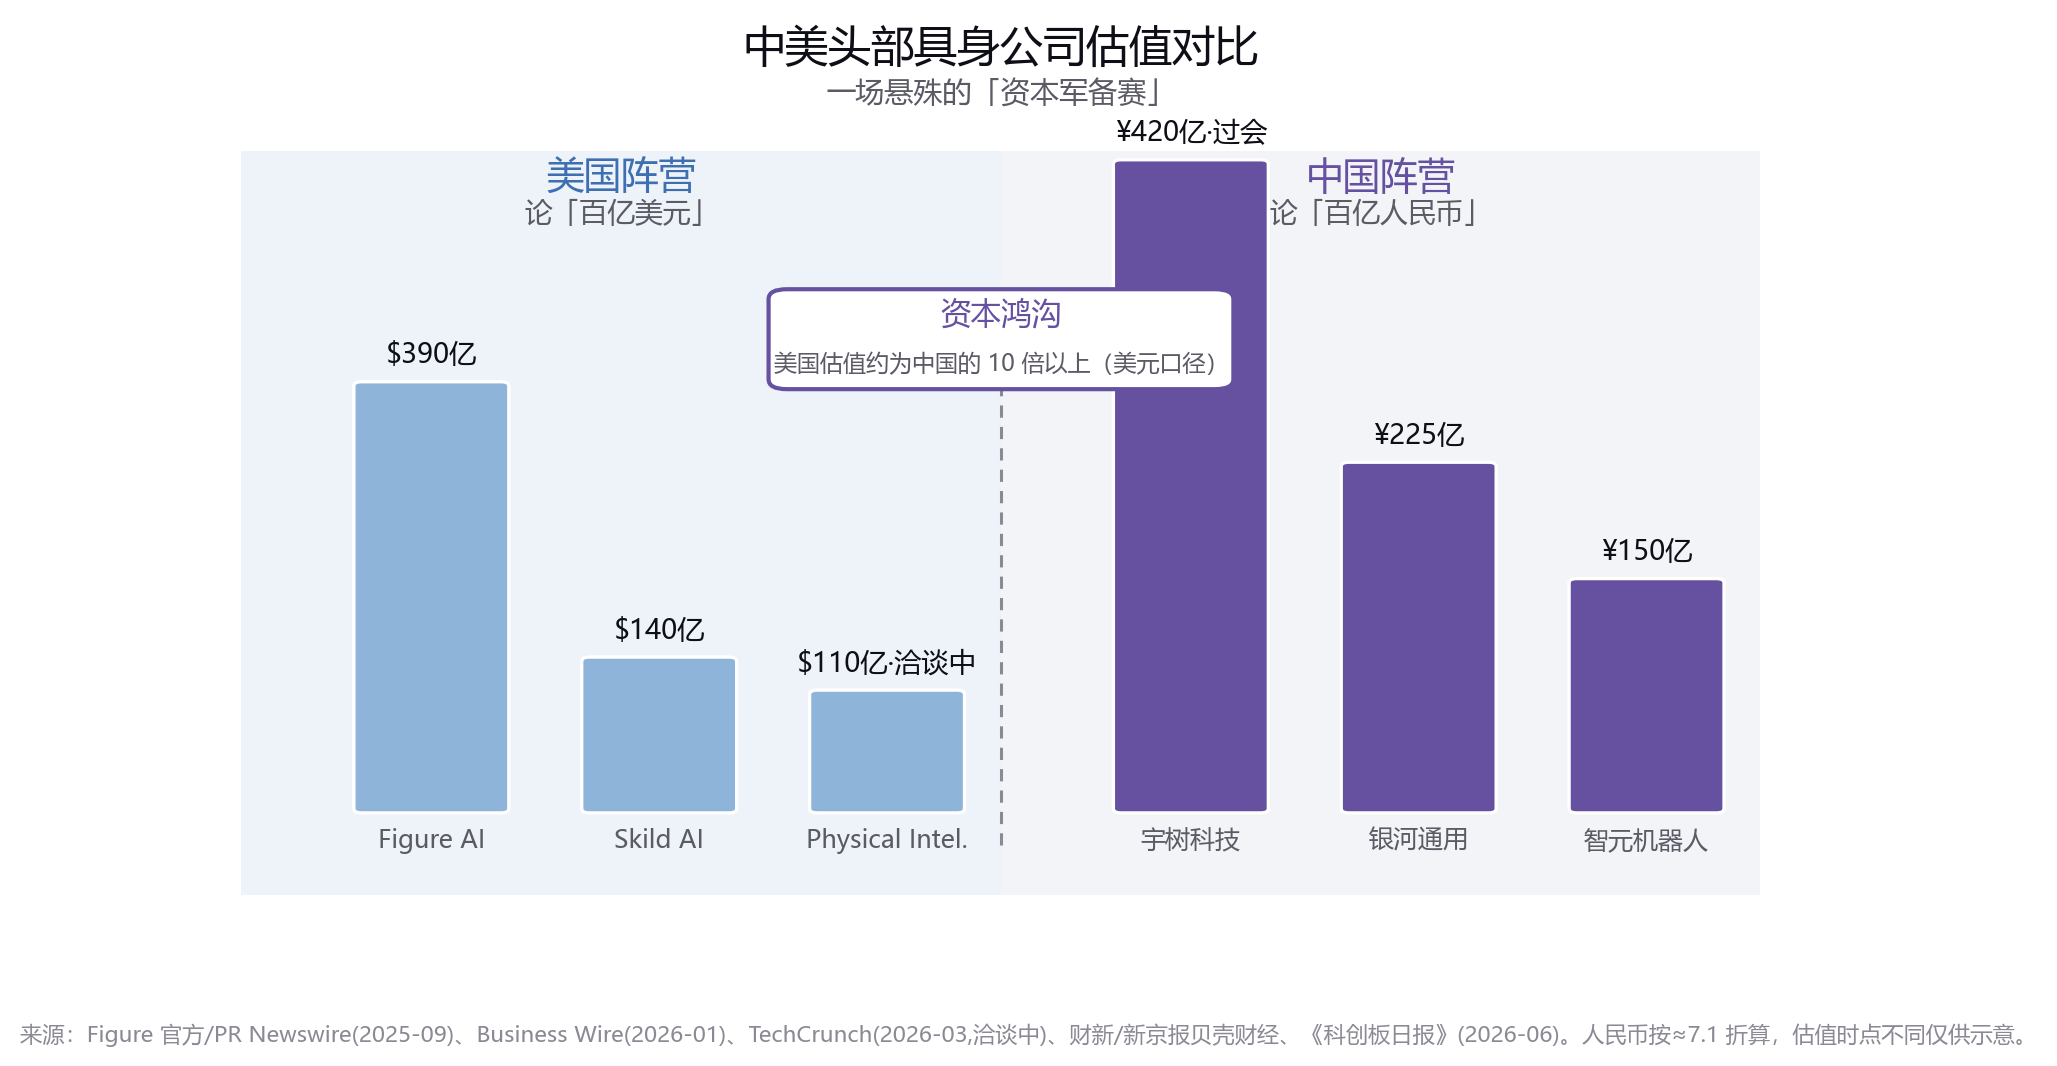
值得玩味的是這張估值對比圖背后的結構性差異:美國頭部公司論"百億美元",中國頭部公司論"百億人民幣"。換算成美元,中國估值最高的玩家也不過二三十億美元量級,而 Figure 一家就近 400 億美元。資本量級的鴻溝,恰恰逼出了中國"用工程效率和數據規模彌補資本差距"的另類打法——這是后文要講的中美分野的伏筆。
二、數據為什么先賺錢:稀缺、剛需、資本外溢
數據生意能夠搶跑,背后有三層邏輯。
第一層,極端稀缺,而且是結構性的稀缺。
截至 2026 年初,全球高質量真實物理交互數據的總量,據澎湃科技的行業測算僅約50 萬小時——不足大語言模型訓練語料的兩萬分之一。這是什么概念?如果說訓練 GPT 的文本數據是一片海洋,那么今天全行業能用來訓練機器人的真實數據,不過是一只水桶。
更棘手的是"數據跟著本體走":不同品牌機器人的傳感器布局、控制模態各不相同,遙操作采來的數據高度綁定特定硬件,很難跨本體復用。這意味著稀缺不是暫時的供給不足,而是結構性的復用困境。
第二層,剛性需求,且在指數級膨脹。
當機器人從實驗室走向工廠、物流、商超,數據需求從"實驗室級"陡然躍升到"部署級"。光輪智能聯合創始人楊海波稱,2026 年的數據需求"百倍于去年"——單一任務訓練就需千小時級數據,復雜任務更多。需求曲線陡峭上揚,供給卻卡在水桶大小,價格信號自然清晰。
據澎湃科技,具身數據當前總體定價 200–500 元/小時;其中真機數據最貴,達 500–1000 元/小時;不依賴特定機器人的"無本體數據"價格約為真機的二分之一到三分之一。

第三層,資本外溢。
本體賽道的投資門檻被推高后,擠不進牌桌的資金轉向商業化確定性更強的上游。一位投資人對媒體直言:"上游在商業化可預測性方面比機器人本體還要穩當——押注的不是某一家公司能不能活下來,而是整個行業對數據的剛需。"
換句話說,賭本體是賭"誰能贏",賭數據是賭"這場仗一定要打"。后者的確定性,顯然更高。
三、技術底座:VLA 與世界模型,把數據"吃"進模型
數據之所以成為戰略籌碼,是因為新一代具身"大腦"對數據的胃口空前。
VLA(視覺-語言-動作)模型成為主流范式。 Physical Intelligence 的 π 系列是標桿:π0(2024 年)是首個通用機器人基礎模型,π0.5 實現開放世界泛化,π0.6 已能在舊金山一家洗衣店穩定疊衣服商用。Google DeepMind 的 Gemini Robotics(2025 年 3 月)把物理動作變成模型的新輸出模態;其 1.5 版本(2025 年 9 月)升級為多本體 VLA,可跨機器人遷移技能。
世界模型成為新前沿。 DeepMind 的 Genie 3(2025 年 8 月)能由一句文本實時生成 720p、24fps、可交互數分鐘的虛擬世界,被視為破解數據瓶頸的鑰匙。而就在 2026 年的 NVIDIA 技術盛會上,黃仁勛明確拋出一個判斷:僅靠真實世界數據,不足以訓練物理 AI——因為現實世界的復雜度與長尾邊緣場景太多。NVIDIA 的解法,是把自己的算力轉化為稀缺的數據原料:其合成運動生成管線,11 小時即可生成 78 萬條合成軌跡,相當于約 6500 小時、九個月的人類演示數據;合成數據與真機數據結合,可將 GR00T 模型性能提升約 40%。
關鍵在于:無論架構如何演進,這些模型都必須用海量、高質量、可迭代的數據來"喂養"。模型越強,對數據的質量與多樣性要求越苛刻。這正是數據成為戰略咽喉的根本原因。
四、中美分野:兩條路徑,兩種死穴
這是本文的核心判斷:中美正走向兩條截然不同的具身數據供給路徑,而且各有致命弱點。

美國路徑:仿真 + 世界模型,重算力、重算法、重資本。
NVIDIA 是這條路的總設計師。它用 Cosmos 世界基礎模型、Isaac GR00T、Omniverse 仿真平臺,搭起一座"數據工廠",本質是把算力轉化為數據原料。Tesla 則走"本體即數據工廠"的垂直閉環——據其 AI 軟件副總裁 Ashok Elluswamy 在 2025 年 10 月 ICCV 的披露,Optimus 與 FSD 共用同一個"神經世界模擬器",這是一種從真實世界視頻中學習而來的"學習式仿真",可在霧天、暮光等不同條件下批量生成合成邊緣案例。
美國陣營內部也有"真實數據派":Generalist AI 堅持用 27 萬小時真機數據訓練 GEN-0 基礎模型,采集自全球數千個家庭、倉庫與工作場所,每周新增超 1 萬小時。
美國路徑的死穴:sim-to-real 鴻溝。仿真環境的物理規律無法完全復現真實世界的復雜性,模型在仿真里表現優異、到真實場景卻容易"翻車"。重算力買得來算法,卻買不來真實世界的"手感"。
中國路徑:真機數采 + 數據工廠,重勞動力、重場景、重政策。
中國把數采變成了一門"制造業"。截至 2026 年 4 月初,全國規劃或建成的具身數采中心、創新中心與訓練場已達 64 座、覆蓋至少 27 個城市。智元在上海浦東建起 4000 平米專屬工廠,日均產出數萬條高質量數據;京東更計劃兩年內采集 100 萬小時機器人本體數據 + 1000 萬小時人類真實場景視頻,發動數十萬人眾包采集。
政策是強力推手。具身智能連續兩年寫入相關政府工作報告;國家數據局推動"數據要素 ×"行動與數據資產入表;中國還首發了具身智能領域首份行業標準——《YD/T 6770—2026 人工智能 關鍵基礎技術 具身智能基準測試方法》,已于2026 年 6 月 1 日正式實施。
中國路徑的死穴:成本、效率與孤島化。遙操作單小時有效數據成本仍在 500 元以上,一套設備超 20 萬元,操作員門檻極高,真機數據很難快速規模化。更致命的是數據孤島——跨本體、跨品牌的數據格式難以互通,任何一條單獨的路線都撐不起通用具身智能的未來。
但請注意一個正在發生的趨同: 2026 年,雙方都在向"混合策略"收斂。中國行業加速轉向"強化中層仿真 + 夯實底層人類數據",以降低對昂貴真機數據的絕對依賴;美國的 Tesla、NVIDIA 也都強調真機 + 仿真 + 合成的多源融合。沒有人押注單一數據源。
五、最危險的認知誤區:被高估的"真實數據萬能論"
講到這里,必須給所有具身廠商潑一盆冷水:"真實數據一定優于合成數據",并不是一條已被證明的定律。
大語言模型的"GPT 時刻"建立在相對清晰的 Scaling Law 之上。但在機器人領域,數據的 Scaling Law 缺乏同等清晰的定義——"數據是否越多越好",本身就是一個需要實驗驗證的開放命題。
學術界的證據是混合的。清華團隊的研究《模仿學習中的數據 Scaling Law》發現:環境與物體的多樣性,遠比單一環境下演示的絕對數量更重要——一旦每個環境/物體的演示量超過某個閾值,再增加演示,收效甚微。
但反方向的證據同樣有力。Georgia Tech 與斯坦福的EgoMimic 研究(CoRL 2024)發現:用智能眼鏡采集的人類第一人稱(egocentric)數據,可使任務表現較純機器人數據提升34%–228%;而且"2 小時機器人數據 + 1 小時人類手部數據"的組合,明顯優于"3 小時純機器人數據"。

這意味著:真實數據(尤其是 egocentric 人類數據)的邊際效用,是一個需要逐場景、逐任務實驗驗證的可測試假設,而非可以絕對化的營銷口號。
真正決定模型能力上限的,從來不是"真實"或"合成"的標簽,而是數據的——多樣性、物理真實性、可評測性與合規性。
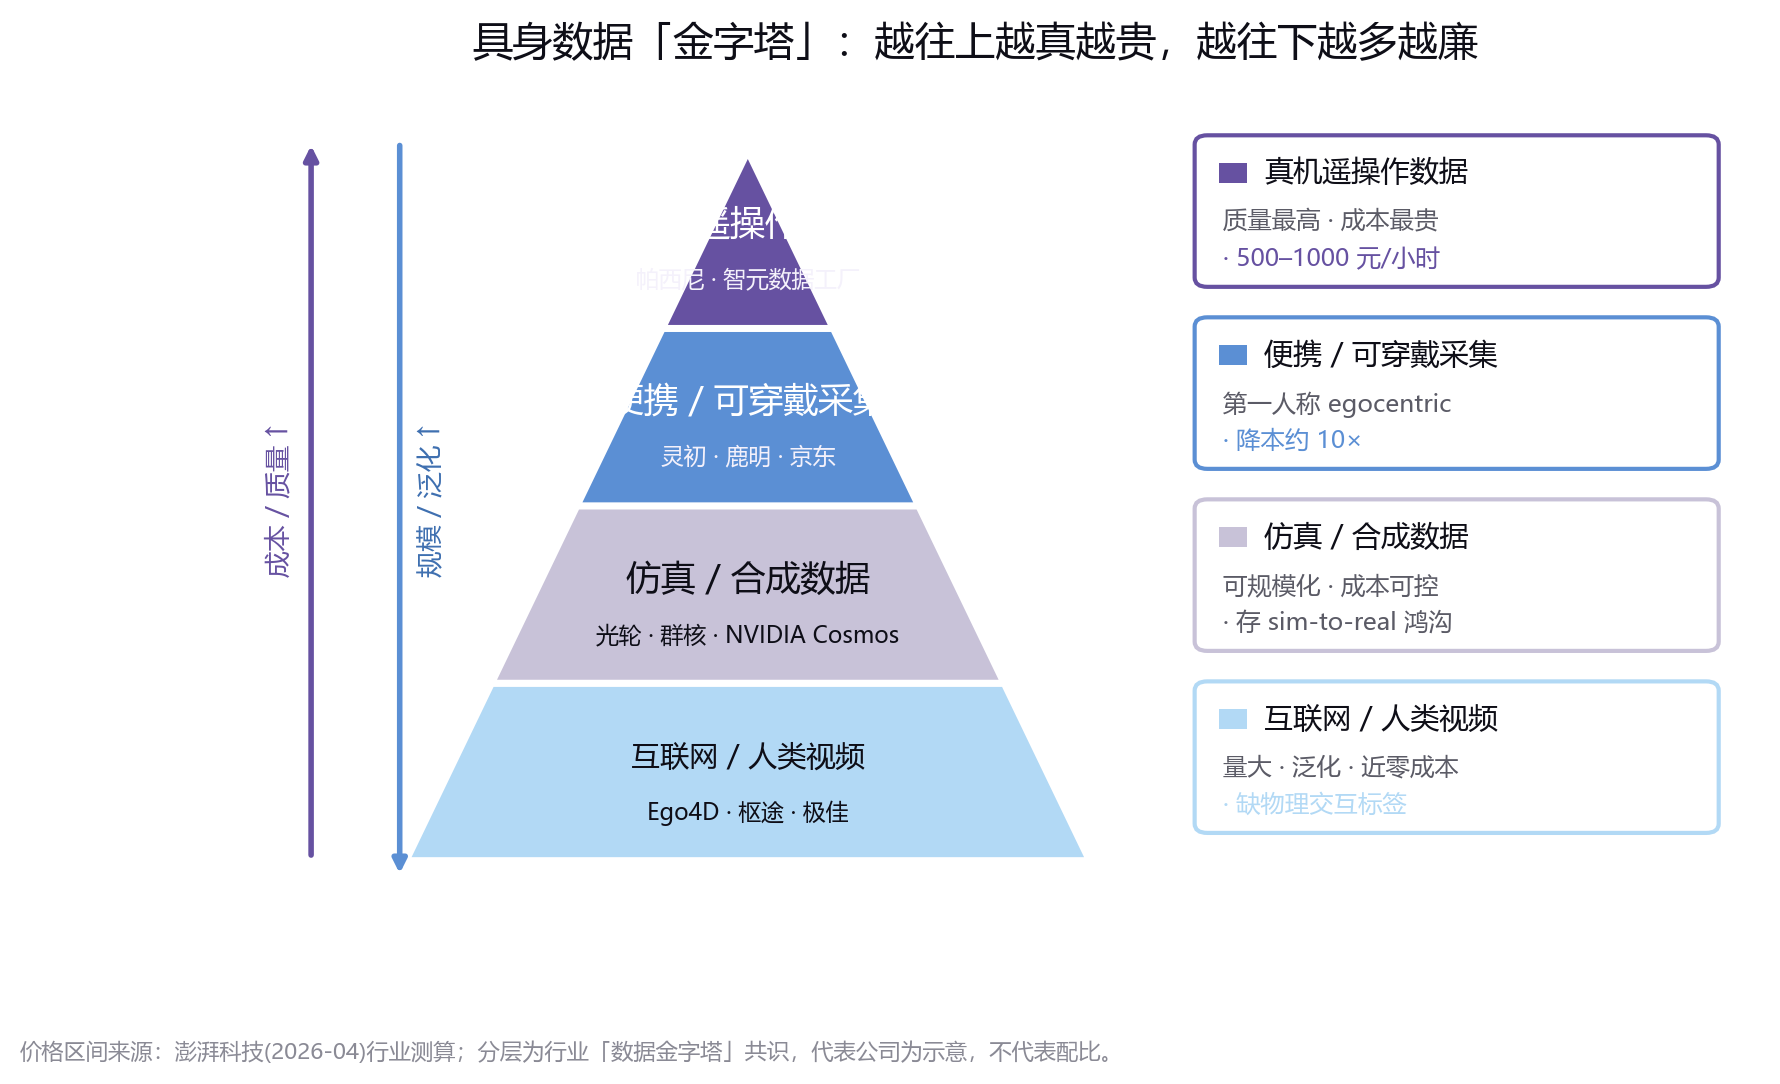
對廠商的啟示因此清晰:與其盲目堆砌某一類數據,不如建立一套"持續、可迭代、可評測"的數據供給體系。按"金字塔"分層配置數據預算——底層用低成本人類視頻夯實泛化,中層用仿真補足長尾,頂層用高質量真機攻堅精密操作——遠比把任何一種數據奉為圭臬來得明智。
而這,恰恰是數據基礎設施供給方的價值所在。
六、一個值得關注的樣本:以"AI 垂類數據基礎設施"切入價值鏈高位
在這場數據戰爭中,有一類"中立、合規、干凈"的數據供給方正在浮現,藝恩數據(ENDATA,新三板代碼 871430)是其中值得關注的樣本。
需要先厘清的是:藝恩數據的傳統主業是文娛垂類數據服務(影視、綜藝、社媒內容的大數據分析)。而在 AI 數據基礎設施的浪潮下,它正嘗試把多年積累的"視頻/圖像/文本"三模態數據能力,向大模型與具身智能的訓練數據延伸。這一延伸的邏輯,與本文的判斷高度吻合。
其一,自有 egocentric 數據資產,踩中行業風口。據公司介紹,其儲備了第一人稱視角的 4D 數據集(公司自述規模 5PB、5000+ 小時,VLA-ready)。這一方向恰好與學界驗證一致——前文 EgoMimic 已證明人類 egocentric 數據的高訓練效率;Apple 的 EgoDex(829 小時 egocentric 視頻、含桌面任務的 3D 手指追蹤)、Tesla 轉向頭盔多攝采集第一人稱視頻,都在押注同一方向。
其二,合規與質量背書,是被低估的稀缺資產。這一點有一個絕佳的反面教材:2025 年 6 月,Meta 以約 143 億美元入股數據標注巨頭 Scale AI 近半股權,結果引發 Google、OpenAI 等客戶因數據保密與競爭沖突而減少合作。這恰恰說明,"中立、不與客戶競爭、合規干凈"的第三方數據供給方,本身就是一種稀缺資產。藝恩強調的合規視頻、干凈 IP 鏈,正是大模型廠商最看重的護城河。
其三,清晰的戰略分層,與行業"數據金字塔"共識吻合。據其對外闡述,它把具身數據價值鏈拆為三層:仿真層(最高價值/最高稀缺,長期競爭力)、渲染層(依托合規視頻的當下現金牛)、規劃層/VLA(隨 VLA 模型爆發的 2026 增長重點)——這是一條"先做現金牛、再爬價值鏈"的務實路徑。
需要特別強調的是:藝恩并不宣稱真實數據絕對優于合成數據。恰恰相反,其立場與本文一致——真實數據的邊際效用是一個需要實驗驗證的開放命題,而高質量、合規、egocentric 的真實數據資產,正是驗證這一假設、并在混合數據策略中占據不可替代位置的關鍵變量。
七、給決策者的三步行動建議
如果你是具身機器人廠商的決策者,面對這場數據戰爭,建議分三步走。
第一步(立即):把數據預算從"附屬投入"升級為"核心預算項",并按層分配。不要把全部預算壓在最貴的真機遙操作上。采用"金字塔配置":底層用低成本人類 egocentric 視頻與互聯網視頻夯實泛化,中層用仿真/合成數據規模化補足長尾,頂層用高質量真機數據攻堅精密操作。基準閾值——單一落地任務先確保千小時級有效數據,復雜任務按倍數追加。
第二步(3–6 個月):鎖定合規、可評測、可跨本體復用的數據供給方,避免數據孤島。優先選擇具備合規認證、有干凈 IP 鏈、能提供 VLA-ready 格式的供給方。對 egocentric/4D 數據資產給予額外權重——它在訓練效率上已有實證優勢,且不綁定特定本體。
第三步(持續):把"真實 vs 合成"當作可驗證假設來管理,而非信仰。 在自有場景做 A/B 實驗,量化每類數據的邊際效用,動態調整配比。一個可操作的決策基準:若某類數據增加后模型成功率提升低于 5 個百分點,就該停止堆量、轉向提升多樣性或切換數據類型。
對中美路徑的戰略判斷: 中國廠商的真機 + 場景優勢,在工業、商超等"剛性場景"落地上短期領先,但務必同步布局仿真與人類視頻數據,以對沖成本與孤島風險;切忌迷信"采得多就贏"。

市場的大方向是確定的——據 QYResearch 預測,全球具身智能數據市場將從 2024 年的 7.53 億美元增長到 2031 年的 67.52 億美元,CAGR 約 36.8%。但在這條高速增長的賽道里,勝出的不會是采集數據最多的人,而是最先建成"持續、可迭代、可評測、合規"數據供給體系的人。
當 AI 從數字世界邁入物理世界,真實交互數據已成為決定具身智能上限的稀缺生產要素。讀懂數據,就讀懂了具身智能的下一程——這或許是這場全球競賽,留給所有參與者最重要的一條共識。
轉自:鷹潭新聞網


【版權及免責聲明】凡本網所屬版權作品,轉載時須獲得授權并注明來源“中國產業經濟信息網”,違者本網將保留追究其相關法律責任的權力。凡轉載文章及企業宣傳資訊,僅代表作者個人觀點,不代表本網觀點和立場。版權事宜請聯系:010-65363056。
延伸閱讀




