
一個智能體會解題,不意味著它會與其他智能體共事。
在真實世界中,智能體不僅需要理解環境,還要面對持續變化的人、機器人與軟件系統:判斷對方的意圖、預測對方的行動,并根據反饋不斷調整自身策略。這種“思考他者如何思考”的能力,是智能體從獨立執行走向協作行動的重要基礎。
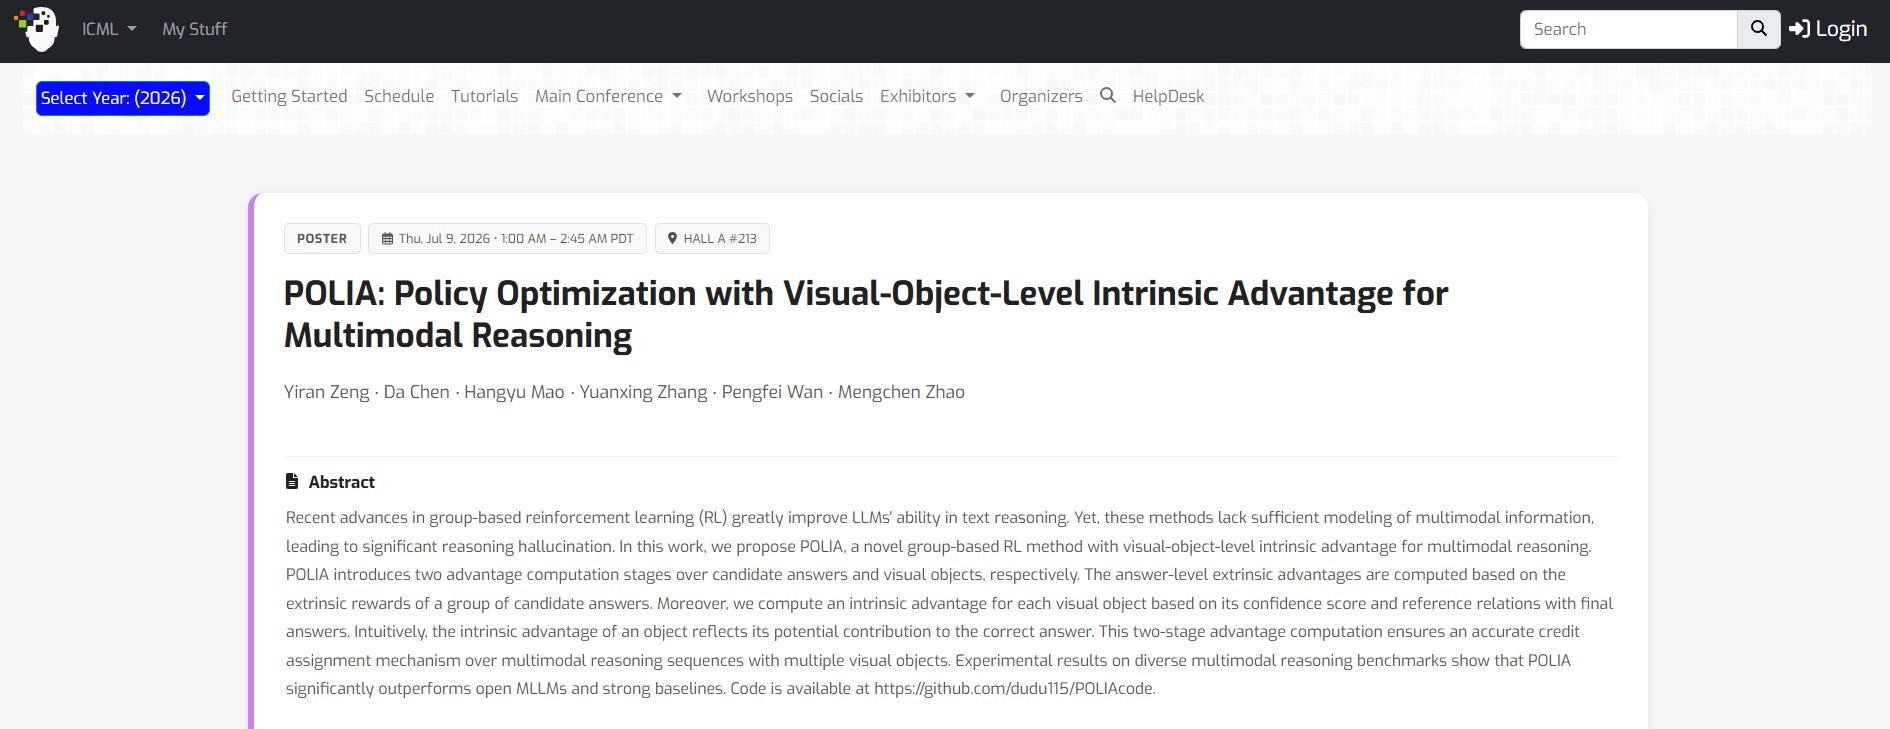
繼多模態推理論文POLIA之后,云蝶科技科研團隊趙夢辰老師指導并擔任通訊作者的第二項研究成果《Strat-Reasoner: Reinforcing Strategic Reasoning of LLMs in Multi-Agent Games》在第43屆國際機器學習大會(International Conference on Machine Learning,ICML 2026)發表。這也是云蝶科技科研團隊在同一屆ICML上發表的第二項研究成果。
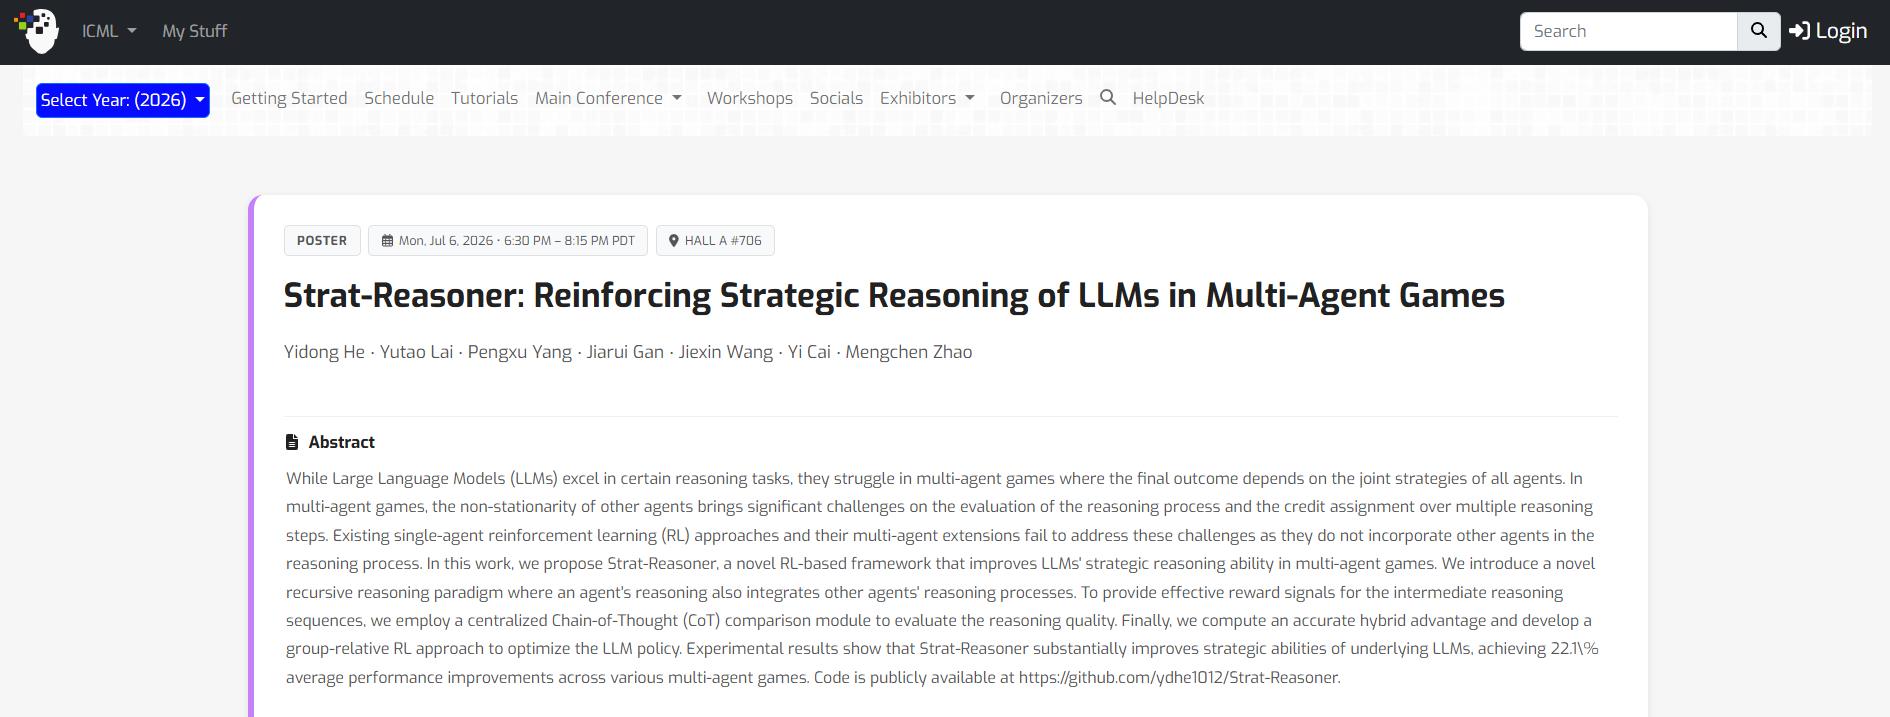
Strat-Reasoner:讓智能體學會“推演他者”
傳統大模型擅長回答問題、生成代碼和完成數學推理,但這些任務通常可以被視為單一模型面對一個相對穩定的問題。
多智能體環境則完全不同。其他參與者也會觀察、判斷和改變策略,最終結果由多個智能體共同造成。僅依據輸贏給予獎勵,很難判斷模型中間哪一步推理正確,又在哪一次對他者意圖的理解中出現偏差。
Strat-Reasoner是一套面向多智能體博弈的強化學習框架。它讓模型在采取行動前,依次思考對方上一輪的意圖、對方如何判斷自己、自己當前希望實現的目標,以及對方下一輪可能采取的行動。
模型因此不再只計算“我下一步應該做什么”,而是把其他智能體的意圖、判斷與潛在行動共同納入決策。
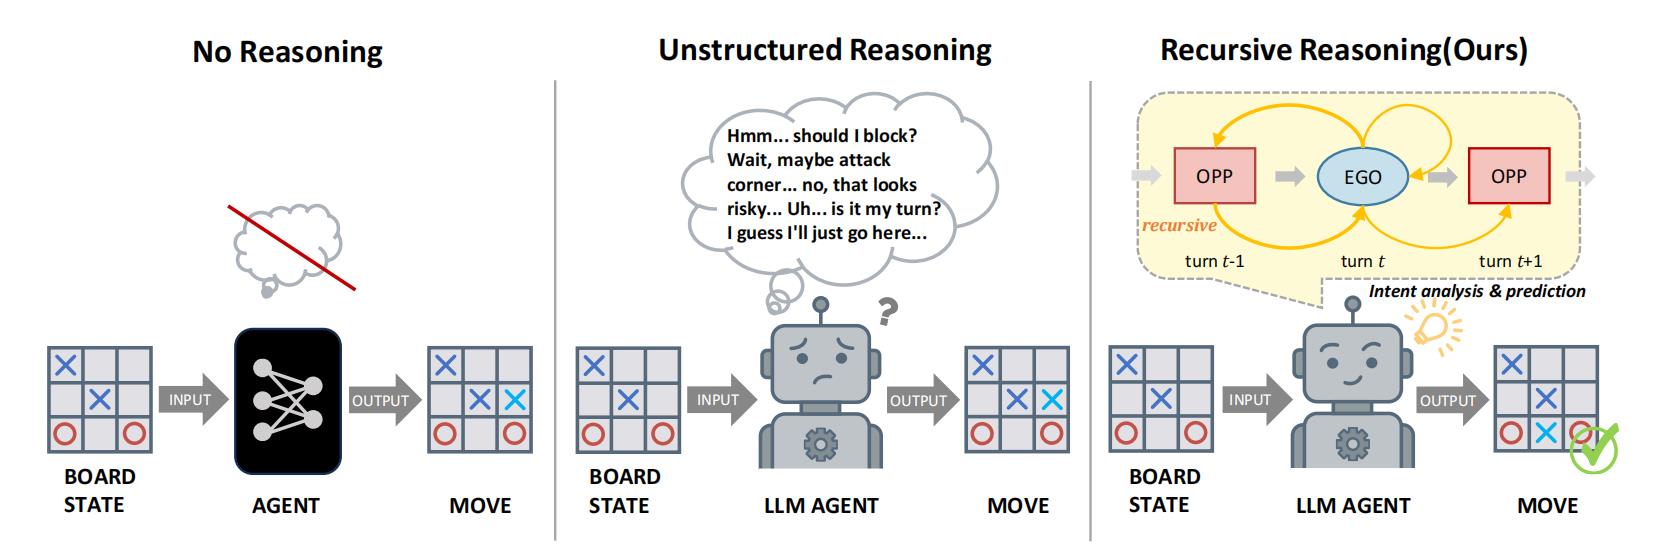
Strat-Reasoner讓智能體顯式分析并預測其他智能體的意圖和行動
在訓練過程中,系統還會將模型對對方的預測,與對方實際表達的意圖和最終行動進行比較,再結合整場博弈結果,共同優化模型的戰略推理能力。
通俗來說,傳統強化學習主要判斷“最后贏沒贏”;Strat-Reasoner還會繼續追問:你是否真正理解了對方?你的預測是否被下一步行動驗證?最終結果來自有效推理,還是偶然發生?
Strat-Reasoner把過去難以直接監督的“揣摩他者”,轉化為可以結構化、比較、反饋和優化的訓練對象。
論文以Qwen3-4B為基礎模型,在三類多智能體游戲、超過500局評測中實現平均22.1%的戰略表現提升。在Kuhn Poker兩種行動順序測試中,其得分均高于GPT-5-mini和Gemini 2.5 Flash。
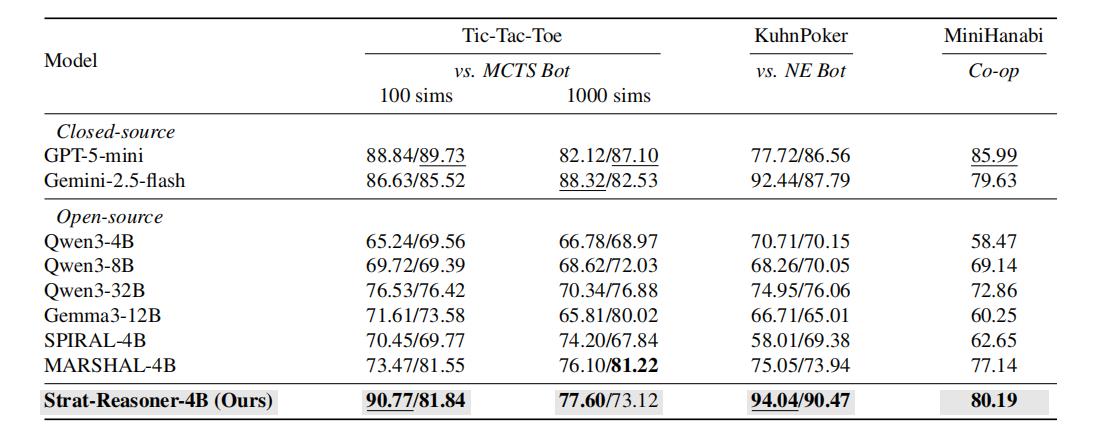
實驗還顯示,Strat-Reasoner在未參與訓練的游戲環境中仍保持較強表現,說明模型學習到的戰略推理方式具有一定的跨環境遷移能力。
同屆兩項成果:從“看對”到“讀懂彼此”
POLIA與Strat-Reasoner并不是兩項彼此孤立的研究。
POLIA關注模型能否識別并使用正確的視覺證據,讓判斷錨定真實環境;Strat-Reasoner則將研究進一步推進到多智能體關系中,關注模型能否理解其他行動者的意圖、預測其行為并調整自身策略。
前者解決“我是否看對了”,后者進一步回答“我是否理解了與你共同參與任務的其他智能體”。
從理解環境到理解他者,兩項研究作為云蝶科技和華南理工大學共建的“多智能體具身智能聯合實驗室”的重要成果,構成云蝶科技推進協作式具身智能基礎研究的兩個支點。
聯合實驗室圍繞視覺-語言-動作模型訓練部署、強化學習優化、世界模型輔助決策及真實場景驗證開展研究,持續探索具身機器人在復雜服務環境中的任務理解、行動決策、環境適應與協同能力。
真實世界中的具身智能不會只面對靜止物體和確定指令。它需要理解人的需求,與其他機器人協調任務,響應環境變化,并在不完整信息下持續調整行動。
Strat-Reasoner目前主要在雙智能體交替博弈環境中完成方法驗證,尚不等同于多機器人真實場景落地。但其研究的“理解他者、預測行動、動態調整策略”,正是智能體從單體執行邁向多智能體協作需要解決的基礎問題。
同屆兩項成果發表于ICML 2026,意味著云蝶科技科研團隊正沿著一條連續的研究路線向前推進:讓智能體不僅能夠看懂世界,也能夠理解共同參與這個世界的其他行動者。
未來智能體的競爭,不只是誰能獨立完成更多任務,更是誰能在由人、機器人和系統共同組成的真實世界中理解彼此、協同行動。
轉自:天極網


【版權及免責聲明】凡本網所屬版權作品,轉載時須獲得授權并注明來源“中國產業經濟信息網”,違者本網將保留追究其相關法律責任的權力。凡轉載文章及企業宣傳資訊,僅代表作者個人觀點,不代表本網觀點和立場。版權事宜請聯系:010-65363056。
延伸閱讀




