
8月21至22日,由極客邦科技旗下 InfoQ 中國主辦的 2026 AICon 全球人工智能開發與應用大會·深圳站圓滿舉辦。兩天會程中,近 1000 位開發者、技術專家與產業一線實踐者齊聚現場,圍繞 AI 工程落地、Agent 創新實踐、大模型效率工程、軟件研發全流程重構等多個前沿方向深度交流,共探 AI 應用邊界的無限可能。

本次大會邀請到來自騰訊、阿里巴巴、快手、螞蟻集團、群青智能、智象未來 (HiDream.ai) 、濤思數據、深開鴻、平安科技、數新智能、Google Cloud、華為、EvoMap、京東、OPPO、網易游戲、范式智能、網龍網絡、NoDesk AI、去哪兒、Zilliz、樂享科技、阿里云、TokenSpeed、TTC(True Talents Connect)、中軟融鑫、榮耀、GoodaBrand 桔大出海、TraceLite AI、平凱數據庫(TiDB)、Dify、阿加犀智能科技、騰訊云、Cloudflare、匯豐科技、云器科技、vivo、 Clipto.AI、Yuzo.AI、百度、Inferact、RadixArk、深圳市人工智能與機器人研究院、天府絳溪實驗室交互人形機器人前沿研究中心、浙江大學等 40+ 家企業與研究機構的 70+ 專家與實踐者同臺分享,他們圍繞智能體技術體系、AI 底層基礎設施、AI 工程實踐與產業場景落地、具身智能等方向展開深度分享,多維度拆解 AI 落地路徑,推動前沿技術與產業需求深度對接。
主題演講精彩回顧,輸出產業關鍵洞察
在大會開場致辭中,極客邦科技總編輯趙鈺瑩圍繞「AI 時代的企業進化:重新思考組織、人才與價值創造」展開解讀。她表示,AI 轉型正從工具部署轉向生產關系重構,企業真正的差距不在于是否使用 AI,而在于 AI 能否進入業務閉環并重塑組織與人才。

她指出,當前 AI 應用落地呈現 "百團大戰" 后的價值分化,重數量堆砌、輕效率落地是普遍痛點。 有明確日均 Token 消耗量感知的企業尚屬少數,更多企業是被迫關注成本。絕大多數長尾應用價值稀薄且持續消耗算力,產研開發后無業務部門買單,成本由公司承擔。同時,AI 很少顛覆原有業務邏輯,核心作用在于擴大服務半徑;企業普遍采用雙軌制考核,存量業務以 ROI 衡量,增量創新由一把手驅動。
趙鈺瑩強調,人才變革的關鍵在于團隊化能力建設。 中大型企業正積極起用更年輕的 AI 領導者,FDE 交付人才與全棧工程師價值持續走高。但她提醒不應神化 FDE 角色 ——“即便個人能力再強,大企業組織架構也不允許”,FDE 能力建設應面向團隊而非個人。她進一步提到,組織削減層級的核心邏輯是讓一把手意志有效穿透,轉型路徑因企業規模與物理依賴度而異。 削減層級并非簡單減員,而是層級越少一號位意志越能有效落地,“一號位不一定是 CEO,也可能是團隊 leader”。
趙鈺瑩在最后指出,AI 原生組織的本質是重構生產關系,企業與人才將走向平臺化共生。 未來企業提供品牌、數據、算力與合規基礎,人才提供判斷、創新與責任,智能體負責規模化執行。
吳哲明《從真實產線定義智能 —— 工業具身智能的物理 AI 閉環》
群青智能聯合創始人兼 CEO 吳哲明在主題演講中表示,人工智能已經在數字世界取得顯著突破,但要讓機器在真實物理環境中穩定完成任務,仍面臨感知、工藝、安全和持續運行等多重挑戰。

“判斷工業具身智能是否成立,關鍵不在于機器人能否完成一次演示,而在于它能否獨立承擔一項具有明確經濟價值的勞動。”吳哲明表示,如果機器人比人更貴、更慢,并且仍需人員持續照看,就還沒有真正成為生產力工具。
相較家庭環境,工業現場存在粉塵、強光、反光、裝配偏差等復雜因素,對精度、穩定性和安全性的要求也更高。但工業任務邊界相對明確,質量、節拍、換產效率和設備利用率均可量化,因此更適合率先驗證具身智能的商業價值。
圍繞真實產線需求,群青智能已推動機器人從輔助作業邁向自主作業,并在真實工業場景中持續實現規模化落地。公司通過在工業機械臂末端配置 3D 視覺等傳感設備,構建由自主感知、自主規劃、端側執行和閉環學習組成的工業智能體系統,減少對傳統逐點編程和規則堆疊的依賴。
吳哲明介紹,群青自主研發的青金石物理 AI 架構,將物理約束、工藝機理、專家知識與真實生產數據融合,使機器人不僅能夠識別工件和焊縫,還能夠理解裝配偏差、工藝窗口和安全邊界,并判斷何時應當調整作業方案。
專家在環是該體系的重要組成部分。老師傅對焊縫、軌跡、姿態和工藝參數的每一次修正,都會與修改原因及執行結果共同記錄,轉化為可復用的垂域知識。系統對 corner case 經過訓練、歷史回放和版本驗證后完成數據閉環和能力更新,在滿足安全與質量要求的前提下持續進化。
在產品落地方面,群青智能已形成覆蓋光筆交互、模型驅動與自主作業的具身智能產品體系,以智能感知與決策能力降低機器人使用門檻,讓機器人適應復雜、非標的真實工業場景。目前其產品已在交通運輸、能源裝備和工程機械等行業持續實現規模化應用,覆蓋 30 多家企業,客戶復購率達到 90%,累計沉淀 300TB 以上真實焊接過程數據,典型項目投資回報周期約為 0.5 至 1.5 年,單廠累計完成超過 10 萬條焊縫。
目前,群青智能已加入西門子 Xcelerator 生態體系,并持續推進工業智能在切割、噴涂、檢測等更多工藝場景中的應用。
吳哲明表示,焊接不是工業具身智能的終點,而是驗證物理 AI 能力的重要起點,具身智能的價值不在替代,而在解放:讓機器承接勞動,讓實踐沉淀知識,把人的時間還給判斷與創造。
周經森《AI for Performance,Performance for AI:人工智能時代的性能工程》
浙江大學軟件學院周經森博士在主題演講中表示,大模型訓練與推理資源消耗巨大且昂貴,性能工作不是變得不重要而是更加重要;AI 性能優化需貫穿模型、運行時與系統硬件三層,而數據采集的嚴謹性是一切優化的前提。

他指出,大模型訓練與推理的資源消耗已達到必須嚴肅對待的量級,性能優化直接關系碳排放與企業成本。 當下,推理側 ChatGPT 日成本約 70 萬美元,中小企業月均支出可達 2 萬美元。IEA 預測 2030 年 AI 數據中心年耗電達 465 TWh,僅 10% 優化即可節省 46.5 TWh。
對此,周經森認為,AI 性能優化必須貫穿模型、運行時、系統硬件三個層次。 模型層可通過量化和稀疏激活降耗;運行時層需解決 KV Cache、調度協同與 HBM/CPU 內存分層問題,在某些場景將非關鍵 KV 移至 CPU 內存可顯著降本;系統硬件層差異更大,同一算法從 Python 改為 C 再用 AVX 向量化指令可獲數量級提升,但 AVX 在 ARM 平臺需換 SVE,跨硬件通用優化仍是難題。
周經森強調,數據采集的嚴謹性是性能優化的前提,microbenchmark 的高提升不等于端到端收益。他提醒 FlashAttention 微基準提升 3 倍但端到端僅 30%(Amdahl 定律),且同一模型不同指標結論可能翻轉,例如 DeepSeek-V3 訓練能耗是 Llama 的十五分之一,但單次推理能耗反高約兩倍。最后他表示,性能工作正從數據中心走向工廠與邊緣。他建議對任何人給出的性能數據應先懷疑準確性,建立最小驗證集,保留優化數據作為下一代模型燃料。
陶建輝《從模型競賽到數據基建:工業 AI 的落地拐點》
濤思數據創始人 & CEO 陶建輝在主題演講中直言,工業企業談 AI“雷聲大、雨點小”,大模型真正進工廠的很少;根源在于數據煙囪、標準不統一、情景化缺失三大問題導致 AI 所需的數據基礎設施絕大部分企業沒有準備好。他總結企業競爭力四要素:持續打磨的工業本體數據底座、沉淀 know-how 的 Skills、統一知識庫、系統無縫對接。

他指出,數據煙囪、標準不統一、情景化缺失是制約工業 AI 落地的三大核心痛點。工廠里 DCS、SCADA、ERP 等系統彼此孤立;同一事物不同名稱、計量單位混亂(厘米與米、升與立方米),AI 最怕 "同物不同名、同名不同物"。他強調自己公司從 1 月起已無人手寫代碼,但大模型在真實生產場景根本用不上。
對此,陶建輝認為,從時序數據庫到工業本體再到柔性界面,工業 AI 需要完整的技術棧而非一個 MCP 接口。底層時序數據庫負責數據接入、ETL、流計算與實時預警;其上工業本體層通過數據目錄解決測點查找難題,通過數據標準化統一名稱與計量單位,通過情景化為數字賦予上下文和閾值。原子應用將畫圖、算 KPI、規則引擎等確定性任務固化為工具,智能體運行時管理模型、Skills 與多輪 Loop,并把所有頁面變成按鈕,工人無需輸入一句話。
陶建輝表示,AI 最大的價值是將隱性知識變為可復用資產。 他將企業隱性知識歸納為數據知識、文檔知識、規則知識、模型知識、流程知識五種形態,固化為 Skills 和知識庫。 他介紹到,TDengine 特色功能 “無問自推”主動推送用戶該關心的問題,讓數據分析不再依賴行業知識;面板智能解讀一鍵生成分析,事件根因分析可將老師傅幾小時的工作壓縮到幾分鐘。他還提出 "柔性界面" 概念,用戶可通過飛書、微信甚至命令行交互,頁面由 AI 即時生成。
陶建輝在演講最后提到,讓最缺資源的中小企業用得起完整工業 AI,是數據基建的真正價值。 他現場宣布帶工業本體與智能體的完整軟件對全球中小企業永久免費、永久免費升級,不閹割功能與性能。其商業邏輯是免費帶來更多用戶、真實場景暴露真實問題、跨行業反饋持續打磨,最終將 TDengine 做成行業標準,挑戰西門子、施耐德等巨頭壟斷。
潘瀅煒《從 Token 預測到狀態預測:邁向世界模型的原生全模態之路》
智象未來(HiDream.ai)技術合伙人 & 算法科學家潘瀅煒博士在主題演講中梳理了大模型十年演進,指出大語言模型架構已逐漸收斂并走向 Agent 化,多模態模型路徑更為多元、正從多模態邁向全模態,而世界模型正從 VLA 預測動作升級為理解并合成物理世界;智象未來以原生全模態 UiT 架構為基座,從多模態生成邁向世界模型。

他指出,大模型三條技術路線呈現不同收斂態勢。大語言模型技術架構已逐漸收斂,并從通用的預訓練向 vibe coding、辦公助手等 Agent 演進;多模態大模型的技術架構較為多元,從 GAN 到 Diffusion、DiT 再到 UiT,正從多模態跨向全模態,實現 any-to-any 的跨模態轉換;世界模型則從早期 VLA 預測動作,走向 world action model 理解世界,世界建模和行動生成逐步融合。智象未來也經歷了好幾代的架構迭代:2017 年 TGANs-C 用 GAN 生成 低分辨率的視頻,2023 年 UNet 在隱式空間探索語義相關性,2024 年擴散自回歸架構(DiT+AR)在生成質量與效率間找極致的平衡,2026 年跳脫 DiT 推出 UiT 原生全模態架構。
同時,他對比三種不同的模態編碼范式,指出從原始信號出發直接交互,是突破生成質量天花板的關鍵。獨立編碼中視覺經 VAE 有損編碼不可避免丟失細節;交互式編碼摘掉文本編碼器但視覺仍用 VAE,重建誤差仍在;UiT 則扔掉所有獨立編碼器,視覺切分為 patch 直接在 pixel space 進行交互和統一建模,訓練更難但天花板更高,可實現雙向甚至于多向的 any-to-any 轉換。潘瀅煒介紹到,基于該架構的 HiDream-O1-Image 開源版發布即達開源第一,閉源版在 Artificial Analysis 競技場取得國內第一、全球第二,畫面質量與文字渲染準確率均居 top 水平。
潘瀅煒表示,最新發布的 DreamWorld 和 HiDream-O1-World,這些世界模型的核心是利用例如完整的 3D 先驗等知識來引導實現時空與物理的一致性。
DreamWorld 針對單圖生成世界時相機移動導致物體畸變的問題,先用 3D 基礎模型生成完整幾何結構先驗(補齊缺失深度信號),再注入視頻擴散模型做外觀生成,在大視角變化場景下結構穩定性顯著提升。HiDream-O1-World 支持漫游、編輯、交互三種模式,物理一致性評測位列第一。兩大難題 —— 時空一致性(物體漂移、穿模、多輪失憶)通過 3D 先驗注入 Memory 加 Test-Time Training 解決;物理一致性(碰撞、流體、形變反規律)通過難例數據加強化學習來解決。
他最后提到未來架構升級的四大方向:從單一生成模型升級為大小腦雙腦架構,構建長時程記憶與持續學習能力,Agent 群體智能協同與同步完善安全治理。
唐武琛《讓 AI 擁有身體:從大模型邁向物理 AI》
深開鴻 AI 平臺部部長唐武琛博士在主題演講中表示,當前 AI “有大腦、缺身體”,Agent 商業化較好的仍集中在 Coding 領域,工業場景落地不充分的根源在于從數字世界到物理世界的感知與控制鏈路尚未打通。他強調,物理 AI 真正落地需要一套連接萬物、匯聚高質量數據、支撐分布式協同、保障安全可信的統一數字底座。

他指出,統一數字底座必須解決連接、數據、協同、安全四個問題,工業場景對可靠性的要求遠高于消費級產品。底座首先要解決海量異構設備的跨廠商跨協議連接;其次是數據采集的格式對齊與時間對齊,如多模態訓練中機械手數據與人眼視覺必須毫秒級同步;第三是支持多機協同以復用能力、彌補單機算力不足;第四是安全可信,在操作系統層面把小概率事件壓到更小。他進一步強調,高質量數據八要素(真實性、完備性、實時性、一致性、相關性、安全性、可追溯與業務閉環)與原生 AI 全棧,是讓 Agent 真正觸達物理世界的前提。
針對以上行業痛點,唐武琛介紹到,KaihongOS 以四大能力構建物理 AI 統一數字底座:統一 OS 彈性部署,支持從 20KB 到 GB 級靈活適配,讓非數字化設備出廠即聯網;分布式軟總線,實現無線傳輸低時延、自組網和多協議支持(WiFi、星閃、藍牙等),打造空間分布式 Agent 集群;原生 AI 全棧,保障毫秒級狀態反饋的完整鏈路;以及多等級安全防護體系,已通過中國安全審查技術與認證中心及公安部安全檢測認證。
唐武琛著重介紹了開源鴻蒙機器人操作系統項目 M-Robots OS。他指出,該系統致力于推動機器人由單體智能走向群體智能,將算力與感知從本體卸載至空間基礎設施。例如,機器人若本體承載大腦、視覺、地圖及全棧算力,功耗占比接近 50%;M-Robots OS 允許機器人復用周邊設備(如固定攝像頭、麥克風等),獲得“上帝視角”,實現上下游環境信息的共享。目前,該系統已適配樂聚、數字華夏等二十余家廠商,累計下載量接近 10 萬,未來將聯合國內機器人廠商共建具身技術體系。
唐武琛表示,深開鴻始終以推動開源鴻蒙生態建設為己任。面向萬物智聯時代,一個統一、安全、高效的數字底座不是可選項,而是必選項;而深開鴻的開鴻安全數字底座,正是這個必選項的最優答案。目前,開鴻安全數字底座已在數字城市、燃氣、電力、水務、地鐵、港口等十余個關鍵場景落地應用。他在演講最后表示:“希望有一天,華強北出售的每一臺終端,都搭載中國人自己的操作系統。”
多維研討,全方位剖析 AI 工程化議題
分論壇方面,本屆大會精心設置了多個技術專題,圍繞智能體工程、大模型基礎設施、AI Native 研發、機器人與具身智能、超級 App 原生化等方向展開,邀請來自多家企業的一線技術專家,分享 AI 技術在真實業務場景中的工程實踐。

專題體系涵蓋:「Harness Engineering:模型之外的智能體工程」、「AI Infra、推理工程與異構計算」、「超級個體與蜂群智能的共生進化」、「Agent 安全:從風險到可控」、「智能體時代的數據供給與治理」、「邁向機器人 AGI 的關鍵技術與產業實踐」、「大模型效率工程與 Agent 系統實踐」、「AI 原生新范式:Coding Agent 重構軟件研發全流程」、「AI Agent 高價值商業場景實戰」、「超級 App 的 AI 原生化:端智能與用戶體驗重構」,以及由 Google Cloud 團隊出品的「動手實驗室:AI 智能體工程實踐」、由阿里云 PolarDB Agent Lakebase 共創的「Agent-Native 多模態數據底座與實踐」。
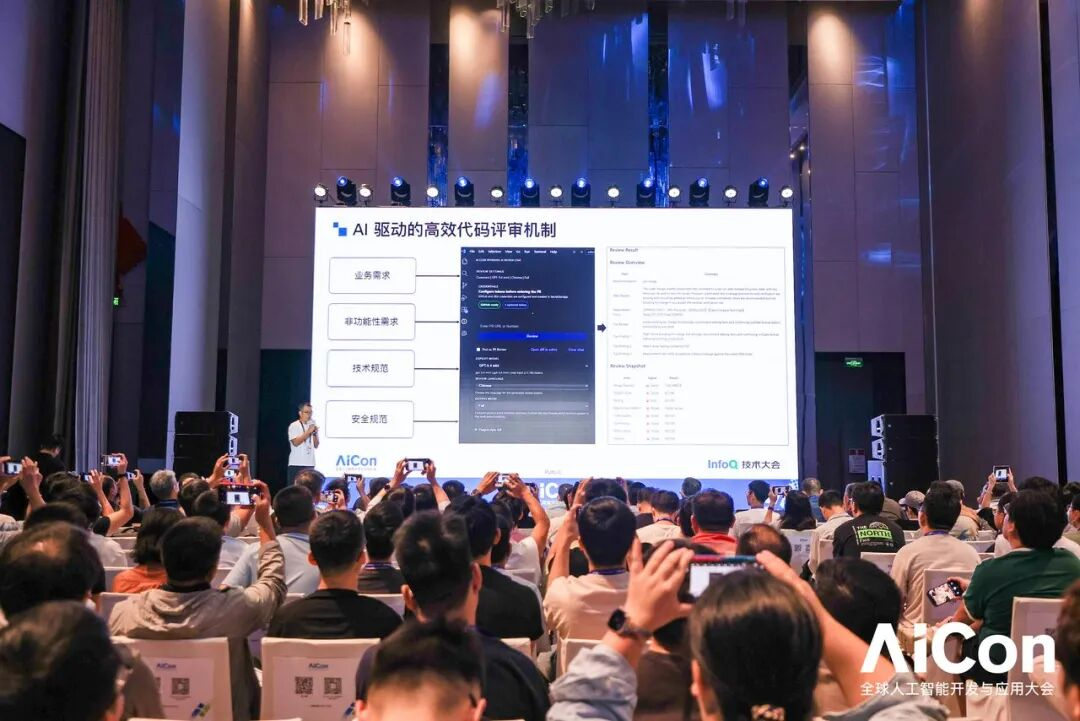
展區聯動,共筑技術生態全景
除主題分享外,大會展區同樣人氣高漲,眾多技術廠商集中展示 AI 應用、開發工具與云服務平臺等最新成果,并設互動體驗環節,讓前沿技術落地可感可及。


本屆 AICon 深圳站的成功舉辦,離不開眾多合作伙伴的鼎力支持!
大會特別感謝阿里云、TDengine、匯豐科技、Google Cloud、科大訊飛、硅基流動、Cloudflare、云器科技、CodingFlow、模力方舟對本屆大會的傾情贊助,同時感謝眾多社區和媒體伙伴的支持。正是因為有這樣一群與開發者同行的伙伴,AICon 才能持續成為推動技術創新與工程落地的核心舞臺。


隨著 AICon 2026 深圳站順利收官,技術探索的熱度將接力至 10 月上海 QCon。期待與更多開發者再相聚,共赴智能時代的下一程探索。
會議推薦
QCon 全球軟件開發大會·2026(上海站)現已正式啟動。本屆大會聚焦 Harness AI 時代的工程實踐,從「構建 AI」到「駕馭 AI」,圍繞 AI Native 架構、Agent Runtime、AI Infra、Agent 安全與可觀測、Loop Engineering、具身智能與世界模型等熱門技術方向,邀請全球技術社區與產業一線實踐者,共同分享 AI Native 時代最具價值的工程經驗。
轉自:中國財富網


【版權及免責聲明】凡本網所屬版權作品,轉載時須獲得授權并注明來源“中國產業經濟信息網”,違者本網將保留追究其相關法律責任的權力。凡轉載文章及企業宣傳資訊,僅代表作者個人觀點,不代表本網觀點和立場。版權事宜請聯系:010-65363056。
延伸閱讀




