

可觀測性查詢面對的從來不只是日志。指標、日志、鏈路、RUM、事件,以及持續增長的資源與業務屬性,共同構成了一個需要被統一檢索的數據面。一次真實的故障排查,往往同時包含服務、環境、地域、狀態、追蹤標識和文本條件,還要排除已知噪聲。當數據量進入千億級,查詢能否秒回,取決于這些條件能否盡早收斂成可組合、可運算的行集合——而不是一堆"可能命中"的數據塊。
GuanceDB 3.1 把倒排與全文檢索完整地落到了可觀測性數據的查詢路徑上。這里說的"全字段",是指不同數據類型中的任意字段都具備建立倒排或全文索引的能力——而非默認無差別地全部建索引;用戶可以按照字段類型和查詢習慣自主選擇策略,把每一份索引成本都花在查詢收益最高的地方。
Bloom 過濾器有價值,但它不是完整的檢索路徑
Bloom 過濾器是輕量的概率型集合判斷結構。寫入一個值時,系統通過多個哈希函數把位數組中的若干位置設為 1;查詢時,只要其中一位為 0,就能確定該值不存在。如果所有位置都是 1,只能得到"可能存在"的結論。只要索引構建、分詞和查詢規則保持一致,Bloom 不會產生假陰性,因此很適合先排除不可能命中的數據塊。
它的代價優勢來自"不保存行號"。但這也決定了 Bloom 只能回答成員關系,不能告訴查詢引擎值出現在哪一條記錄。其理論誤報率近似為:
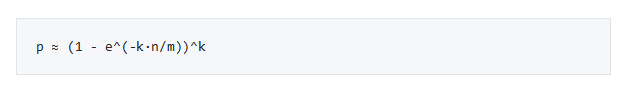
其中 m 是位數組大小,n 是寫入的值或詞項數量,k 是哈希函數數量。固定空間下,字段基數、詞項數或 n-gram 數量不斷增加,更多位會被置為 1,過濾器趨于飽和,誤報率隨之上升。降低誤報需要更大的位數組或重新選擇哈希次數,這會增加索引空間、構建 CPU 和讀取成本。因此,Bloom 的粒度、容量、分詞方式和目標誤報率必須與真實數據分布共同設計。
這里其實存在兩層"誤命中"。第一層來自哈希碰撞:值并不存在,但對應位恰好都被其他值置為 1。第二層來自塊級共現:即使 Bloom 完全沒有哈希誤報,多個查詢值只要分別存在于同一個塊的不同記錄中,這個塊仍然無法被跳過。對于多條件低命中查詢,第二層往往更加關鍵。
設查詢條件為:
service=checkout AND env=prod AND region=sg AND status!=ok
若這些值分別出現在同一個數據塊,塊級過濾器可以分別回答"可能存在",卻無法證明它們在同一條觀測記錄上同時成立。即使最終一條結果都沒有,執行引擎仍可能讀取候選塊、解碼相關列并逐行判斷。數據塊越大、字段越多、條件越分散,候選塊與真實命中記錄之間的差距就越明顯。
不同布爾條件下,這種差異會進一步放大:
●對 AND,Bloom 只有在至少一個條件確定不存在時才能跳過數據塊;各條件分別存在但沒有行級交集時,仍需后置掃描。
●對 OR,只要任一條件可能存在就必須保留數據塊,條件越多,能夠被整體排除的塊通常越少。
●對 NOT、!=、NOT IN,知道"被排除值可能存在"并不能判斷哪些行應當保留。若缺少強正向條件限定候選集,查詢仍可能接近全量讀取。
●對短語和鄰近搜索,基于 token 或 n-gram 的 Bloom 只記錄"這些片段可能出現",不保存詞項所在記錄及位置,通常仍需讀取原文做精確確認。
因此,Bloom 的誤報只影響效率,不會造成錯誤結果,最終結果仍由精確階段確認。它是有效的塊級跳過結構,但不是完整的行級檢索路徑。
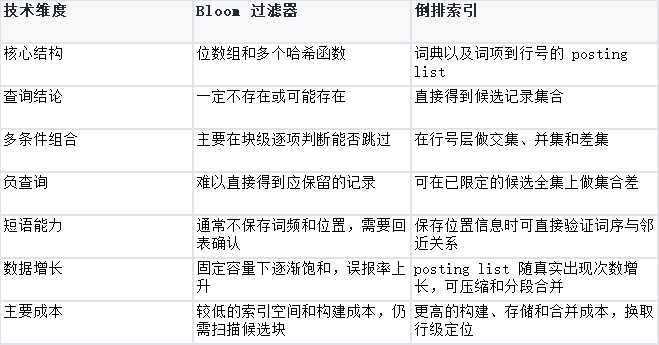
需要說明的是,這并不是"開源產品不好",而是 Bloom 類方案共同面對的執行粒度上限。以可觀測性中的日志子場景為例:Loki 官方文檔將 Bloom 查詢加速標注為實驗性能力,要求使用結構化元數據;可加速的過濾主要是字符串等值、有限的與/或和可簡化正則,且必須出現在解析步驟之前——放在解析之后就不會加速。
VictoriaLogs FAQ 說明,它按字段保存數據塊,用過濾器跳過不含指定詞或短語的塊,并維護時間稀疏索引。該機制擅長排除明顯無關的數據塊;從塊級執行粒度推斷,在低命中、多條件和負查詢中仍可能留下較大候選范圍。

同一查詢、同一數據塊、同一組記錄,差異來自索引能提供的定位粒度。示意中的 r101—r104 是同一個數據塊 B17 的具體記錄,只用于說明執行粒度,不代表任何性能基準。Bloom 誤報只帶來額外讀取,不會改變精確結果;倒排也仍受高頻詞、純負查詢和大返回量的邊界約束。
GuanceDB 3.1:讓復雜條件直接落到行集合
GuanceDB 3.1 為指標標簽、資源屬性、鏈路屬性、RUM 維度、事件字段等結構化數據提供倒排,為日志正文、錯誤信息等長文本提供分詞全文索引。倒排索引先維護字段值或詞項字典,再為每個詞項記錄對應的行號集合。工程實現通常會對遞增行號做差分編碼,或根據密度選擇壓縮數組、位圖等表示,使 posting list 可以按段存儲和合并。
查詢時,執行器不必先讀取字段正文,而是先讀取各條件的 posting list。AND 可以從最短列表開始,通過有序歸并、跳躍指針或位圖運算不斷收窄;OR 直接合并候選;NOT 則在時間、租戶或其他正向條件已經限定的記錄集合上做差。若全文索引保存詞頻或位置信息,還可以在索引層完成短語、鄰近和相關性判斷,而不只是確認詞項曾在某個數據塊出現。
關鍵變化不是"索引更多",而是從塊級"可能命中"提升為行級"候選定位"。對上述組合條件,執行器可優先處理選擇性最高的條件,再與其他列表求交;交集為空時,可在讀取完整記錄前結束。只有真正入選的行才進入列讀取、反序列化和結果組裝路徑。
高、低選擇性查詢可以采用不同候選路徑。稀有錯誤碼、追蹤標識等條件產生短行號表,快速縮小范圍;常見級別或地域對應的 posting list 較長,但仍可與時間、租戶、服務等更強條件求交。需要說明的是,倒排也不是無條件的固定延遲方案:高頻詞會形成很長的 posting list,純負查詢需要一個明確的候選全集,返回量很大時仍受網絡與序列化限制。GuanceDB 3.1 的優勢是讓執行器擁有行級集合和選擇順序,而不是消除所有查詢成本。
把索引成本放到正確的資源池
全字段可索引不代表寫入節點要同步承擔全部計算。GuanceDB 3.1 將寫入、查詢和任務/compaction 節點分離,數據以對象存儲持久化;索引生成、段合并與壓縮由獨立節點完成。
索引或合并任務出現峰值時,可在云上臨時擴展資源,完成后釋放實例,在線容量不必按后臺峰值配置。寫入池可以根據實時吞吐和隊列深度擴縮,compaction 池可以根據待處理分區、段數或字節量從零擴展到多個任務節點。對象存儲承接數據和索引段,讓計算與存儲分別擴展。全字段索引的計算成本因而可控,查詢仍獲得行級定位。
這種任務邊界也更適合利用 AWS Spot 等可中斷算力:寫入彈性層在持久隊列、冪等提交和重試機制保護下承接突發流量;compaction 通過任務租約、checkpoint 和失敗重排安全地使用 Spot,實例被回收后可由其他節點繼續。查詢池則按交互式 SLA 保留更穩定的容量。成本由實際寫入量和待合并數據量驅動,而不是為三類工作負載的疊加峰值長期保留整組機器。
索引建立的節奏也可按查詢收益安排:高頻資源屬性和業務維度優先,長文本按業務語義分詞;沒有索引的字段仍保留通用讀取路徑,兼容可觀測性數據字段持續變化。查詢先按時間、租戶、數據類型和分區收斂范圍,再合并各字段行號集合,最后讀取結果列。這樣,索引覆蓋率和資源投入能夠隨實際負載迭代,不必把所有代價一次壓在在線寫入鏈路上。
對于高基數字段,倒排能夠把單個值的候選直接交給查詢節點;對于低選擇性字段,多個條件的集合運算仍可減少無關數據讀取。查詢返回量過大時,網絡和結果序列化會成為新的邊界,因此秒級目標應以可控返回量和明確時間范圍為前提。后臺合并期間,在線節點繼續服務,峰值資源不必固化為長期配置。

左側為 Elasticsearch 與 ClickHouse 常見的數據節點部署——角色可以有所拆分,但持有分片或數據部件的節點通常仍要承擔寫入、讀取以及 segment merge / compaction;右側為 GuanceDB 的資源邊界——三類計算獨立擴縮,對象存儲承接持久狀態,因此更容易組合 Auto Scaling、按需實例和 AWS Spot。需要留意 Spot 邊界:更低成本來自可中斷任務的安全重試,而不是把所有節點直接替換為 Spot;寫入彈性層需要持久隊列、冪等提交與基線容量,compaction 需要任務租約、checkpoint 和失敗重排,查詢池仍應按交互式 SLA 選擇穩定資源。
與常見方案的機制對比
下表比較過濾機制與資源邊界。
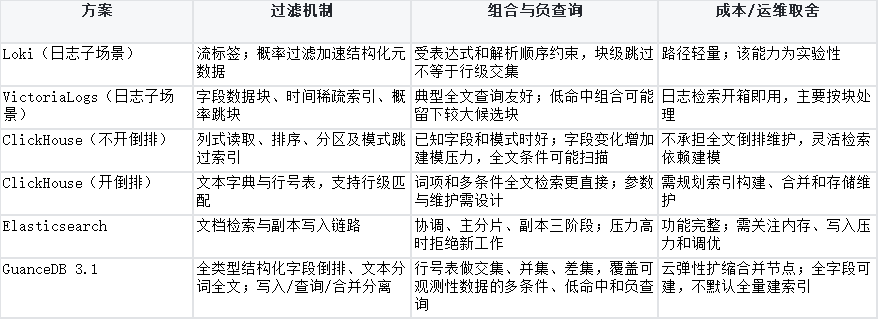
在近乎相同的數據保留和資源預算下,若查詢以跨維度篩選、低命中排查和否定條件為主,GuanceDB 3.1 的行級定位會帶來質的差別;相較日志路徑中的 Loki、VictoriaLogs,或承載可觀測性數據但未開啟倒排的 ClickHouse,這份收益來自過濾粒度的結構性優勢,而不是營銷口徑里的倍數。當然,若只按時間和少量固定標簽讀取,塊級過濾可能已經夠用。
ClickHouse 開啟全文索引、或直接采用 Elasticsearch,確實能獲得更強的檢索能力,但索引構建、段合并、寫入鏈路與副本機制都會帶來額外的資源消耗和運維工作。GuanceDB 3.1 把這些后臺工作拆到獨立的合并與任務資源池,并以對象存儲作為持久化邊界,從根本上卸掉了在線資源的包袱。實際差異取決于字段數量、索引覆蓋率、復制策略、冷熱分層和返回量,我們不用固定百分比代替真實測算——但架構上的分工邊界,是誰都繞不開的。
為什么 GuanceDB 3.1 更強:三個結構性差異
拋開跑分口徑,GuanceDB 3.1 與上述方案的差距是結構性的——它不依賴特定硬件、數據集或參數調優,而是由執行模型和資源架構本身決定。
01 定位粒度:行級集合運算,對塊級概率跳塊
Loki、VictoriaLogs 的加速本質是"塊級跳過":能排除"確定不含"的塊,卻無法證明多個條件在同一條記錄上同時成立,低命中組合查詢仍會留下大量候選塊,逐行確認的成本一點沒少。GuanceDB 3.1 的倒排直接返回行號集合,多條件在索引層完成交、并、差運算,候選集在讀取數據之前就已收斂。這不是"快一點"的優化,而是執行模型的代際差異。
02 覆蓋范圍:全部可觀測性數據,對日志子場景
Loki 與 VictoriaLogs 只解決日志;ClickHouse 不開倒排時,字段持續變化就意味著持續的建模壓力;Elasticsearch 檢索能力強,代價卻是沉重的寫入鏈路與副本開銷。GuanceDB 3.1 讓指標、日志、鏈路、RUM、事件中的任意字段都具備行級定位能力——一次故障排查,不必再在幾套系統之間來回切換。
03 成本結構:獨立彈性資源池,對一體化節點按峰值預留
在 ES / ClickHouse 的典型部署中,寫入、查詢與 merge / compaction 擠在同一組數據節點上,容量只能按三類負載的疊加峰值長期預留。GuanceDB 3.1 將三者拆進獨立資源池:寫入按吞吐擴縮,查詢按 SLA 保持穩定,compaction 按待合并字節從 0 彈到 N、用完即釋放,并可安全使用 AWS Spot。查詢資源,永遠不再為后臺合并買單。
從技術指標到業務價值
索引粒度和資源邊界,最終都要回答同一個問題:它給業務帶來什么?對使用 GuanceDB 3.1 的團隊,答案落在四個最實際的維度上。
更短的故障恢復時間(MTTR)
service=checkout AND env=prod AND status!=ok 這類多條件、低命中的排查查詢秒級返回,值班工程師把時間花在定位根因上,而不是等查詢、翻日志。故障每一分鐘都在燒錢——查詢快一秒,止損就早一秒。
更低的總體擁有成本(TCO)
索引構建與段合并放進獨立彈性資源池,可中斷任務交給 Spot 算力,容量不再按"寫入+查詢+合并"的疊加峰值采購。數據量漲十倍,賬單不必跟著漲十倍。
一套系統,查全部數據
指標、日志、鏈路、RUM、事件統一檢索。少一套系統,就少一份運維投入、少一次排查中的上下文切換,也少一個"數據在別處"的盲區。
讓數據價值被真正消費
查詢夠快,工程師才愿意查;字段隨業務演進即可檢索,無需重建模型。可觀測性投入不再只是"出事時才有用的保險",而是日常排障與業務分析的生產力工具。
這些差異最終體現在三個可衡量的數字上:故障平均恢復時間、單位數據量的查詢成本、工程團隊的人均排障效率。技術先進性是手段,這三件事才是結果。
千億級查詢的正確打開方式
"千億級、秒級"是有前提的工程目標,而不是無條件的服務承諾:索引已構建,查詢限定了合理的時間、租戶和數據范圍,篩選字段具備索引,資源與并發經過規劃,返回量可控。在此前提下,GuanceDB 3.1 通過行號表生成極小的候選集,再讀取必要的列——讓千億級可觀測性數據的常見篩選,穩定落在秒級體驗內。
Bloom 依然是優秀的輕量預過濾手段,先排除確定不存在的數據塊;但當日志、指標、鏈路、RUM 和事件中都頻繁出現多條件、低命中、全文或負查詢時,真正關鍵的是兩件事:條件能否被轉換成可運算的行集合,索引成本能否被獨立、彈性地管理。
GuanceDB 3.1 同時回答了這兩個問題——讓查詢從"盡量少掃"走向"直接定位",把索引工作放進可擴縮、可釋放、可使用 Spot 的云資源池。這既是技術路線的選擇,也是對客戶賬單和值班體驗的承諾。
轉自:新聞晨報


【版權及免責聲明】凡本網所屬版權作品,轉載時須獲得授權并注明來源“中國產業經濟信息網”,違者本網將保留追究其相關法律責任的權力。凡轉載文章及企業宣傳資訊,僅代表作者個人觀點,不代表本網觀點和立場。版權事宜請聯系:010-65363056。
延伸閱讀




