
高通在2026驍龍峰會上正式發布了兩款旗艦移動平臺,其中被外界廣泛猜測的那顆更高定位芯片,最終命名為驍龍8 Elite Extreme Gen 6,中文名叫第六代驍龍8超級至尊版。此前長達數月的爆料中,這顆芯片被廣泛稱為“驍龍8 Elite Gen 6 Pro”,甚至一些海外科技媒體也沿用了這個臨時命名。但高通最終給出的答案很明確:沒有Pro,只有Extreme。Pro本身并不符合驍龍移動平臺的命名傳統,使用“Extreme”作為命名,完全符合高通官方的命名路徑。2025年9月,高通推出的面向超高端市場的筆記本計算平臺就叫驍龍X2 Elite Extreme,Elite Extreme是標準Elite芯片之上的新級別。所以,第六代驍龍8超級至尊版使用Extreme這個后綴,是一脈相承的。
命名的事說清楚了,接下來的問題才是真正值得展開的:一顆5GHz的手機芯片,憑什么讓人相信它不會燙手?一個能跑300億參數模型的NPU,到底想讓手機變成什么?
5GHz不是問題,5GHz能撐多久才是
5GHz本身并不令人意外。高通的Oryon CPU架構從第一代開始就在主頻上走得激進,這一代把Prime核心推到5.0GHz,某種意義上只是把上一代已經逼近極限的數字正式越過了門檻。真正值得關注的是另一個問題:峰值性能能維持多久。
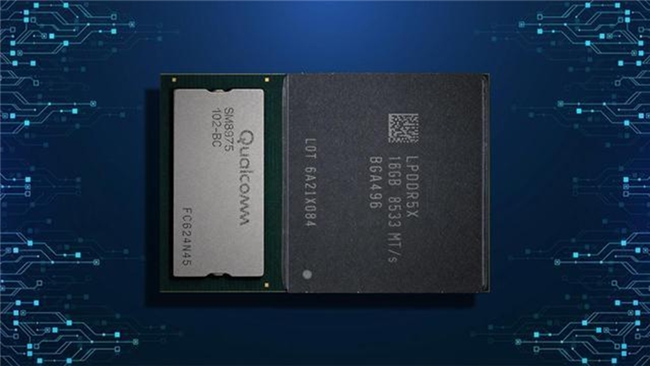
高通對此的回應落在了一個看起來不那么“性感”的地方——封裝。超級至尊版采用了Offset PoP方案,把原本垂直堆疊在SoC上方的內存芯片向側面偏移,在處理器封裝頂部騰出了一塊空間,用于放置銅質散熱塊。高通高級副總裁兼手機業務總經理Chris Patrick在驍龍峰會上說得很直白:“更快將熱量導出、讓SoC維持更低溫度,系統就能在最高性能區間停留更久。”
這個改動的物理邏輯很簡單。過去約10年,高通在8系平臺上一直采用PoP封裝,將內存垂直堆疊在SoC上方。這種結構下,LPDDR內存的布線無需經過主板,可直接在封裝內部完成,但內存本身也成了一層隔熱屏障,散熱材料很難直接接觸處理器封裝的核心區域。把內存挪到一側之后,芯片上方可鋪設導熱材料,形成一條通往手機散熱模組、熱阻更低的傳熱路徑。
實測數據很有說服力。在第三方測試中,采用Offset PoP的超級至尊版達到105℃溫度閾值需要915秒,超過15分鐘;而采用傳統PoP封裝的上一代旗艦芯片,達到同樣溫度只需要390秒,約6分半。也就是說,峰值性能的持續時間延長了超過一倍。Chris Patrick將這顆芯片比作“賽車引擎”:日常功耗較低,但在需要時可以釋放極高的峰值性能;而當峰值性能維持更久時,系統響應會更快,整體體驗也會更流暢。
GPU層面的能效優化同樣服務于這個目標。Adreno 850的GPU性能提升44%,能效提升40%,配合首次引入的Adreno Matrix Cores和Adreno Neural Fusion技術,AI超分和幀生成可以直接在圖形管線內部完成。在高通參考設備上的實測中,使用自研基準測試Traverse Evolve,開啟ANF超分后游戲幀率從原生17.7幀提升至49.2幀,提升幅度178%;而在同等幀率條件下,功耗從6.2瓦降至1.1瓦,約為原生狀態的六分之一。這個數字的意義不在于省電本身,而在于把省下來的功耗預算留給了持續性能輸出。
這背后是高通手機業務高級副總裁Chris Patrick所強調的:“ANF不是采購來的現成方案,而是高通從底層開始設計的自有技術。”從封裝到GPU再到AI引擎,功耗問題被當成一個系統級工程來解,而不是靠單一模塊的優化。
300億參數的意義不在大,在不需要你等
端側大模型這件事,過去幾年的敘事一直圍繞“參數規模”展開。但到了驍龍8 Elite Extreme Gen 6這一代,敘事重心發生了變化。
驍龍8 Elite Extreme Gen 6可以本地運行超過300億參數的MoE模型。這不是它第一次被提及的數字。真正的新信息在于它怎么跑,以及跑起來之后用戶感知到什么。
MoE架構的關鍵在于:雖然總參數量達到300億,但每次推理只激活其中一小部分參數,計算成本遠低于同規模稠密模型。這意味著模型可以“裝進”手機而不壓垮功耗和內存。
高通的硬件底座為此做了三件事。第一,Hexagon NPU引入了專為Transformer工作負載打造的Element Accelerator,并將大容量共享內存擴容50%,讓模型狀態和中間張量保持在NPU附近,減少對外部系統內存的往返訪問。第二,配合LPDDR6內存和UFS 5.0閃存,模型權重可以從閃存高效加載,通過存儲與計算協同減少對運行內存的持續占用。第三,Sensing Hub搭載雙Micro NPU,性能提升85%,可支持最高2億參數的AI模型持續低功耗運行,支撐全天候的情境感知。
軟件層面,高通攜手階躍、無量火與江波龍開展的四方合作,在不修改模型結構、不損失推理精度的前提下,使階躍StepEdge-Omni 30B-MoE模型的運行內存需求較行業常規方案降低超50%。實測數據方面:預填充吞吐超過330 Token/s,解碼吞吐超過28 Token/s,首個詞元生成達到毫秒級。
這些數字翻譯成體驗就是:從郵件理解、行程規劃、日歷同步、航班酒店推薦到郵件草擬,整個智能體工作流全程本地完成,無需云端調用,用戶不需要等待。
智能體時代的“以人為本”,是讓技術痕跡消失
高通CEO安蒙在峰會主題演講中給出了一個判斷:行業正從“以手機為中心”的體驗模式,邁向“以智能體為中心”的新時代。而高通從一開始就是人本AI變革行業的引領者和開創者。安蒙將智能體體驗的衡量標準概括為三個維度:可信、毫不費力、情境化。可信意味著安全和用戶控制權始終在用戶手中;毫不費力意味著使用智能體必須比自己動手更簡單;情境化則要求體驗個性化、主動服務而非打擾。
他舉了一個例子:智能體提醒用戶喜歡的樂隊來到所在城市,在獲得用戶授權后,用戶只需回答“是的”,后續的日程協調、門票購買、行程規劃全部由智能體跨應用、跨服務協同完成。所有復雜性隱藏在幕后,呈現給用戶的體驗卻非常簡單。
這才是超級至尊版在AI層面最值得關注的信號。它的NPU性能提升35%、每瓦性能提升33%、共享內存擴容50%、支持32K token上下文窗口——這些參數的意義不在于“更強”,而在于讓智能體可以在本地持續運行而不打擾用戶。它不需要每次響應都喚醒云端,不需要把用戶數據傳出去,不需要用戶在每一個環節確認。它安靜地運行在后臺,理解你的習慣,在你需要之前就已經準備好了。
安蒙在演講中特別提到,權限與控制必須始終掌握在用戶手中。這也是端側智能體和云端智能體最本質的區別:數據不出設備,智能體才能真正成為屬于用戶的智能體。
轉自:鷹潭新聞網


【版權及免責聲明】凡本網所屬版權作品,轉載時須獲得授權并注明來源“中國產業經濟信息網”,違者本網將保留追究其相關法律責任的權力。凡轉載文章及企業宣傳資訊,僅代表作者個人觀點,不代表本網觀點和立場。版權事宜請聯系:010-65363056。
延伸閱讀




